「AI モデル 使い分け」に「Plan Execute」が添えられた検索は、当サイトの観測所で2026年9月19日から10月23日まで、観測に出た日数が25日の問いです。最初の問いは「計画は重いモデル、実行は軽いモデル、という分け方の具体策と実測の差」でした。25日後の問いは「モデル名だけでなく、実行主体・版・人の検収も分担したい」です。モデルの選び方の話が、仕事の分担表の話になっています。
- 分けるのはモデル名ではなく、「仕事の性質」「動く場所」「人が見る所」の3つです。モデル名はその結果として決まります。
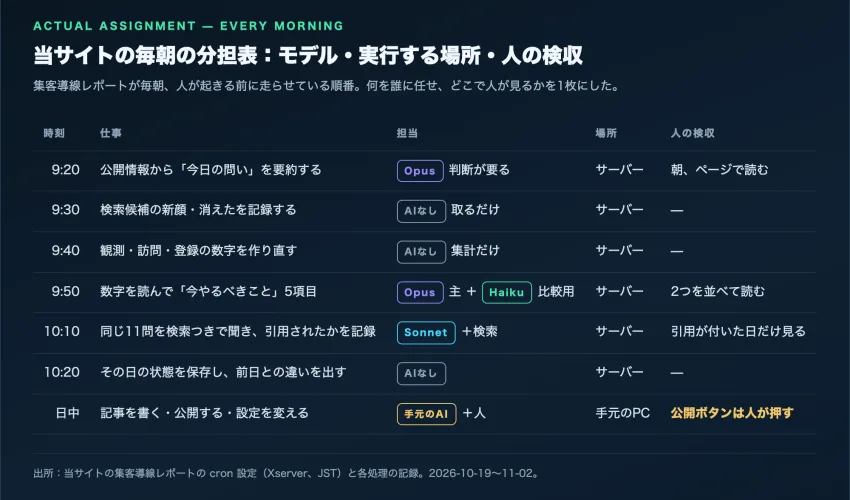
- 当サイトの毎朝の分担は、判断が要る2つの仕事に大きいモデル、照合できる1つの仕事に中くらい、集計には使わない、外に出る操作は人です。分担表を1枚にして本文に置きました。
- 「Plan は大、Execute は小」は、当サイトの実測では半分だけ当たりでした。同じ入力で15日間並走させると、一番の候補は毎日同じで、違いは「次の切り口」を出すかどうかでした。
問いは「どのモデルか」から「誰が・どの版で・誰が検収するか」へ
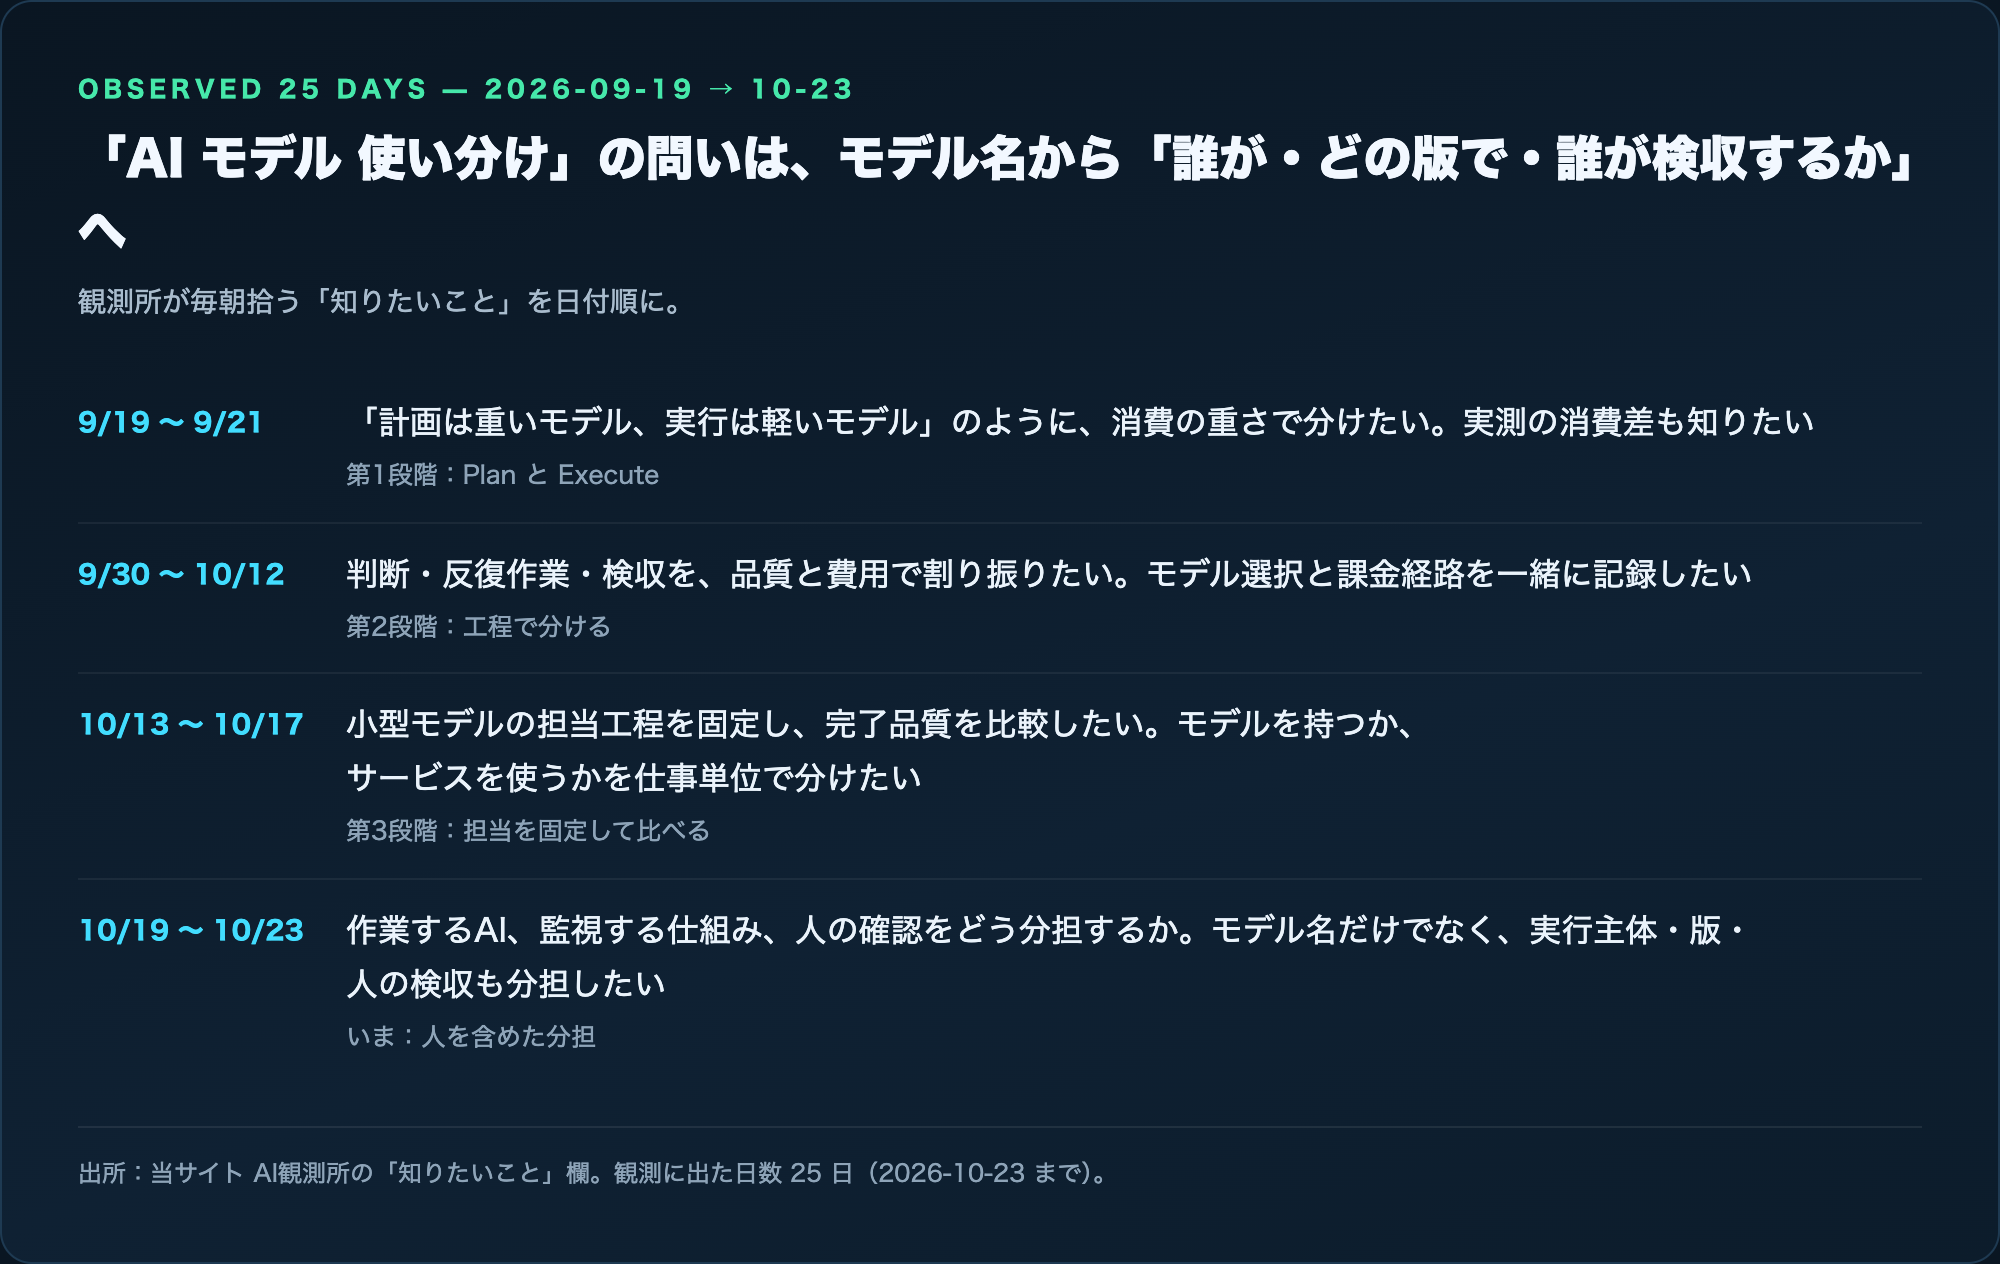
9月の問いは、使う量の重さで分ける話でした。9月末から「判断・反復作業・検収を品質と費用で割り振りたい」になり、10月中旬には「小型モデルの担当工程を固定して完了品質を比べたい」、最後は「作業するAI、監視する仕組み、人の確認をどう分担するか」です。モデルを2つ用意しただけでは終わらず、どの工程を誰に渡し、どこで人が検収するかまで決めないと運用にならない、と気づいた人の問いだと読めます。
当サイトの分担表:毎朝、人が起きる前に走る順番
当サイトの「集客導線レポート」は、毎朝サーバーの上で6本の処理が順に走り、日中は人が手元のAIと記事を書きます。何をどのモデルに任せ、どこで人が見るかを1枚にしました。
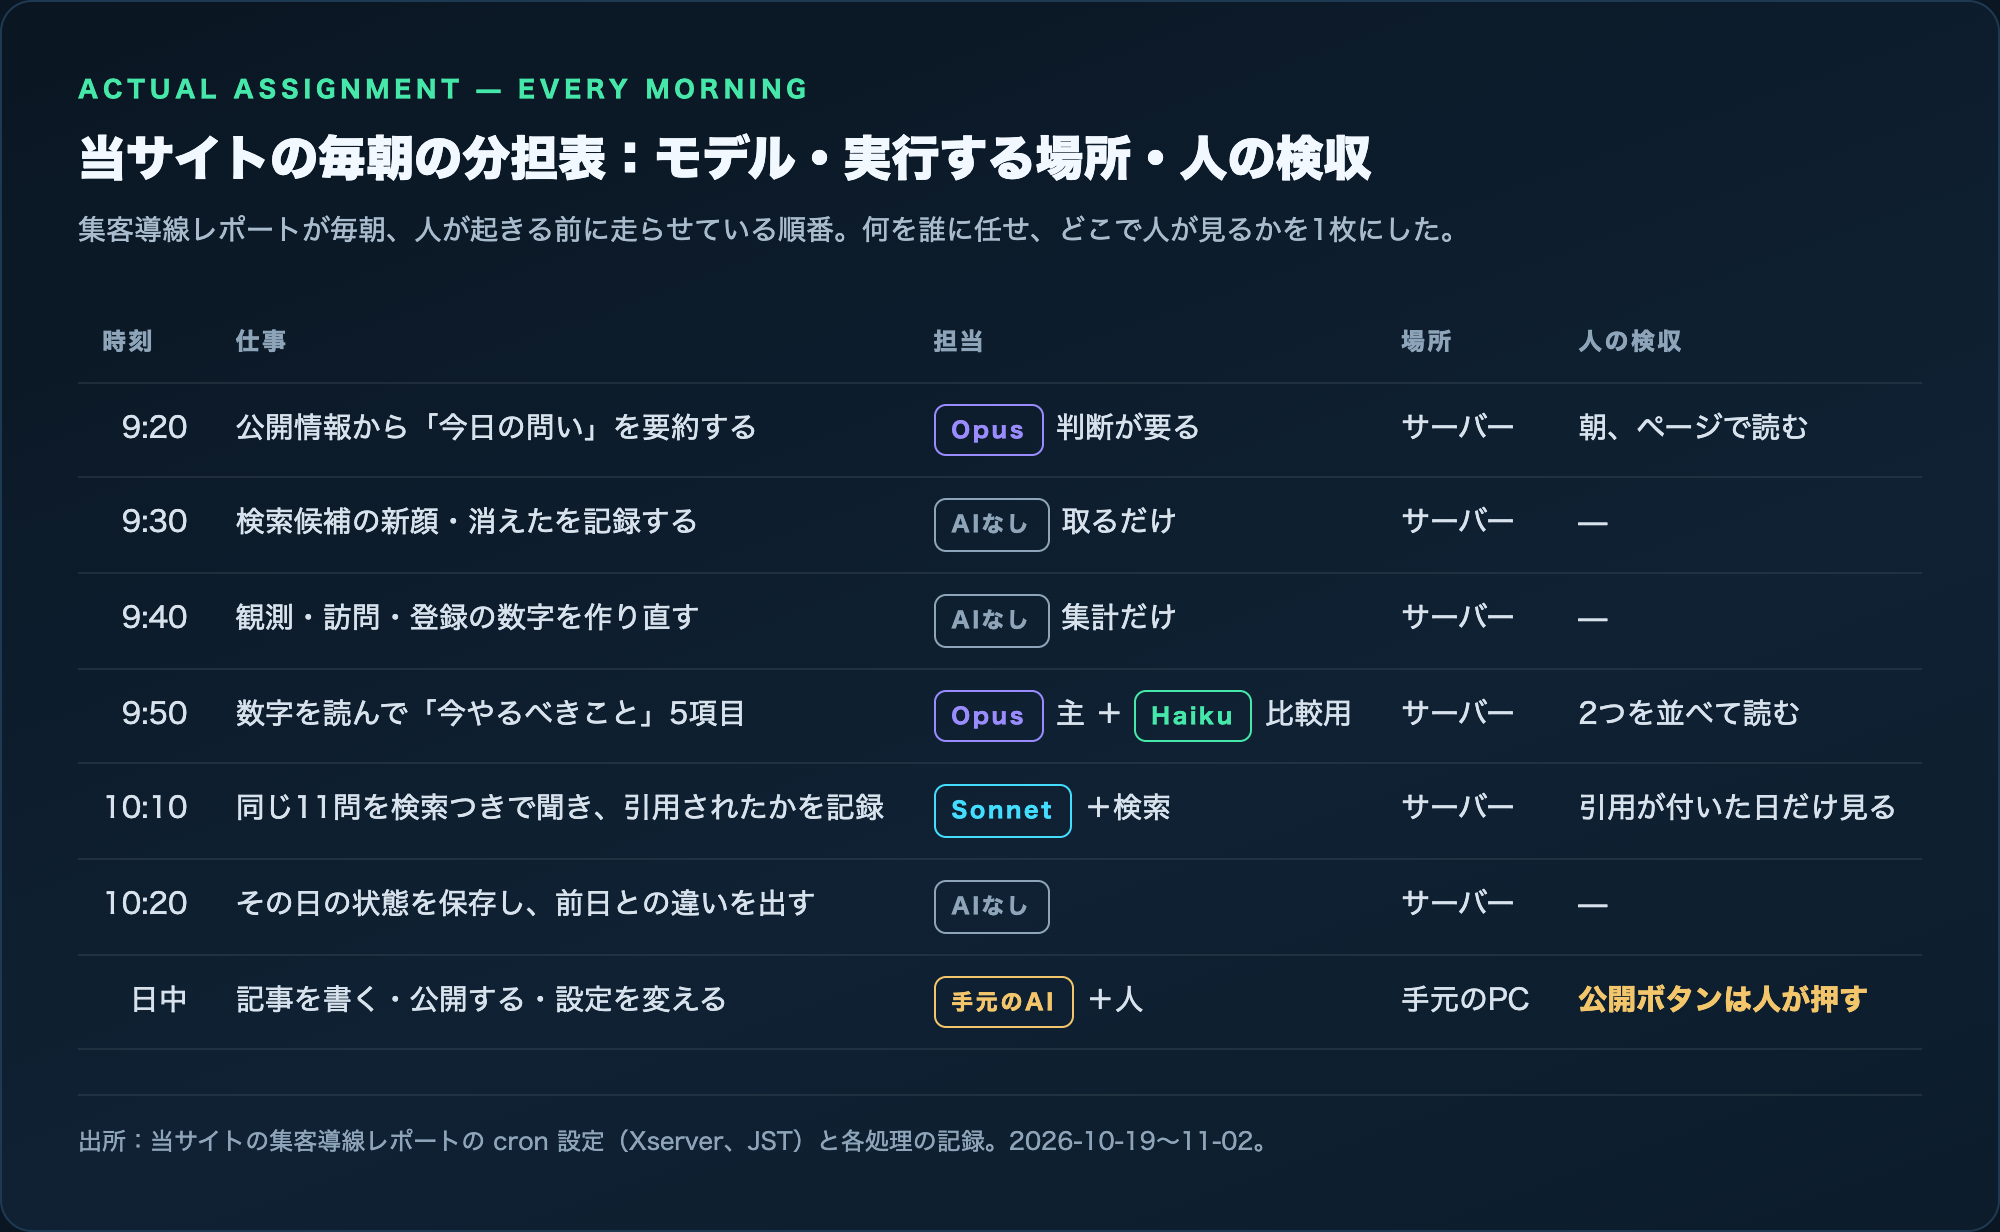
分担の決め方は3段階です。まず仕事の性質。「毎日違う素材から問いを立てる」「数字を読んで次を考える」は判断が要るので大きいモデル。「同じ11問を毎日聞いて引用の有無を記録する」は結果を機械で照合できるので中くらいのモデルと検索。「候補を取る」「数字を集計する」はそもそもAIを使いません。次に動く場所。毎日決まって動くものはサーバー、作るものは手元。最後に人が見る所。朝にページを読む、2つのモデルの出力を並べて読む、公開ボタンを押す。この3列が埋まると、モデル名は自然に決まります。
実測:「計画は大、実行は小」は半分だけ当たっていた
「今やるべきこと」を出す仕事は、主に大きいモデルを使い、比較のために小さいモデルを毎朝同じ入力で並走させています。15日間の結果はこうでした。
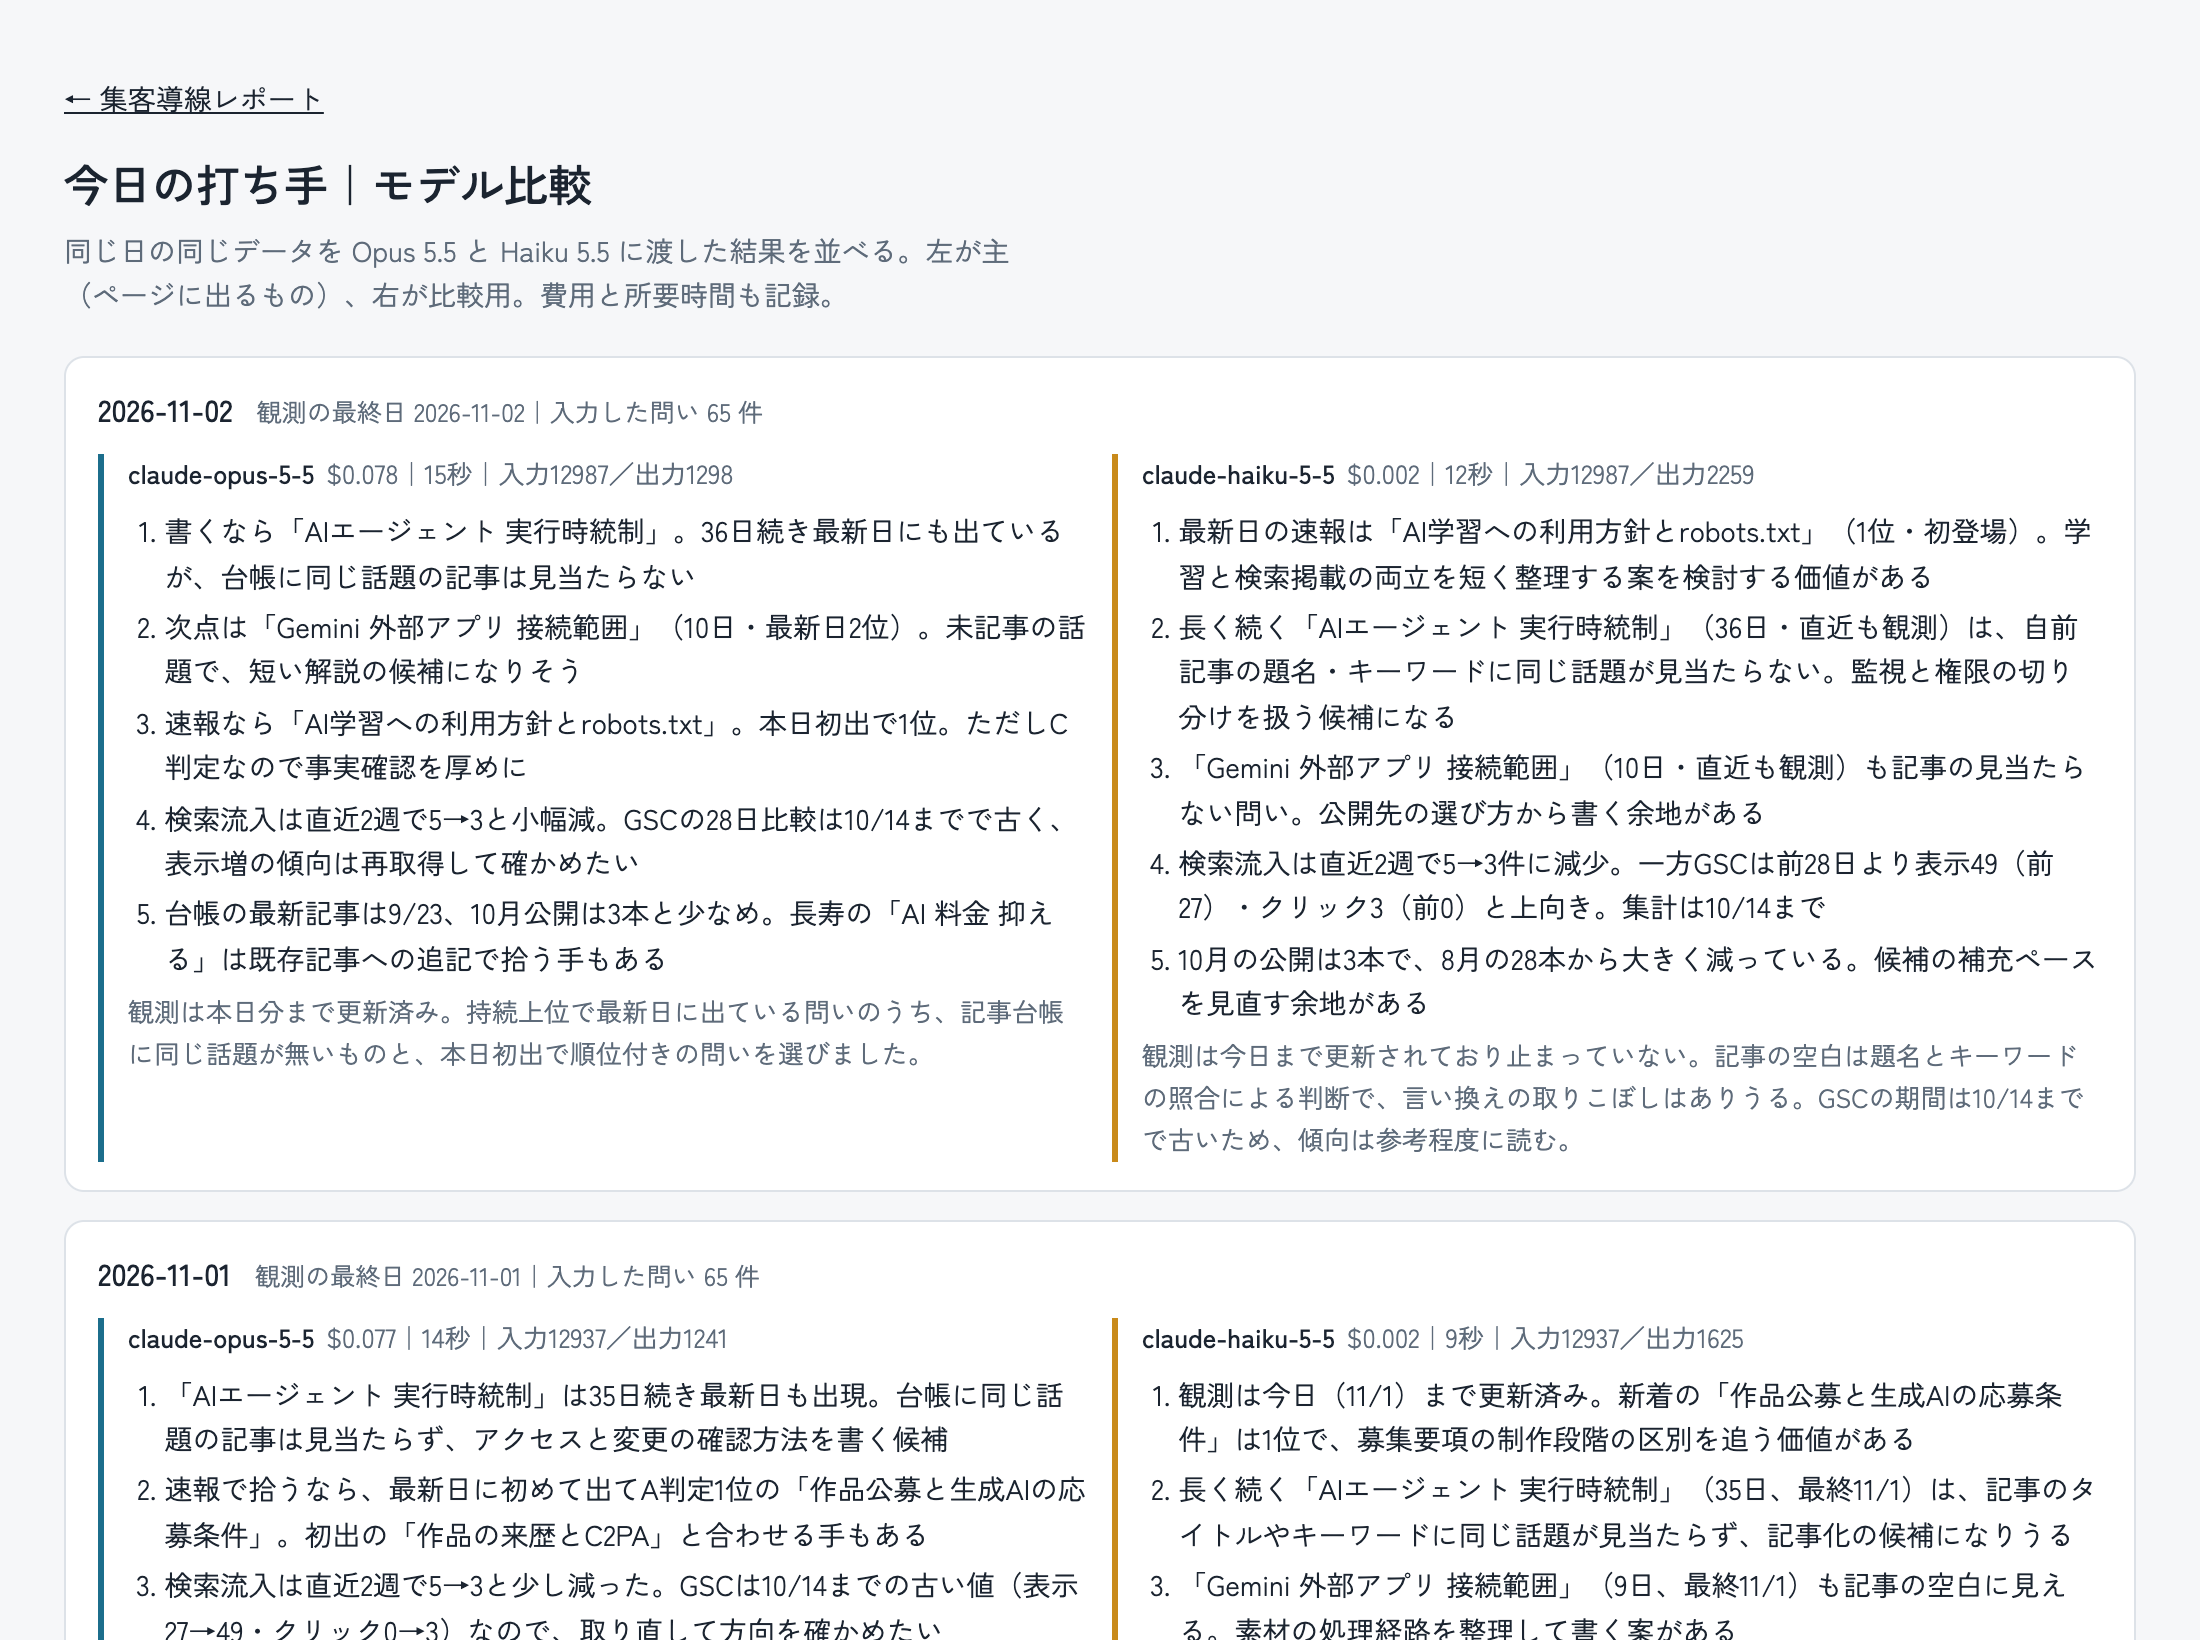
「何をすべきか」の結論は毎日同じでした。この点では「実行は小さいモデルで足りる」が当たりです。外れたのは「計画」の側です。計画とは「次の切り口を考える」ことで、ここだけは大きいモデルの出力が違いました。たとえば「設置場所と実行権限を分けて整理する記事」という切り口は、小さいほうからは出ていません。つまり分けるべきは「計画か実行か」ではなく、「合格条件を文で書けるか、次の切り口を考えてほしいか」でした。
「版」と「人の検収」を分担表に入れる理由
観測の最後の問いにあった「版」は、モデルが切り替わる日のことです。並走の仕組みがあると、新しい版が来た日に同じ入力を渡して、合格条件で照合するだけで済みます。当サイトでは、比較用の列がそのまま「版の変更を受け入れるかどうか」の試験台になっています。
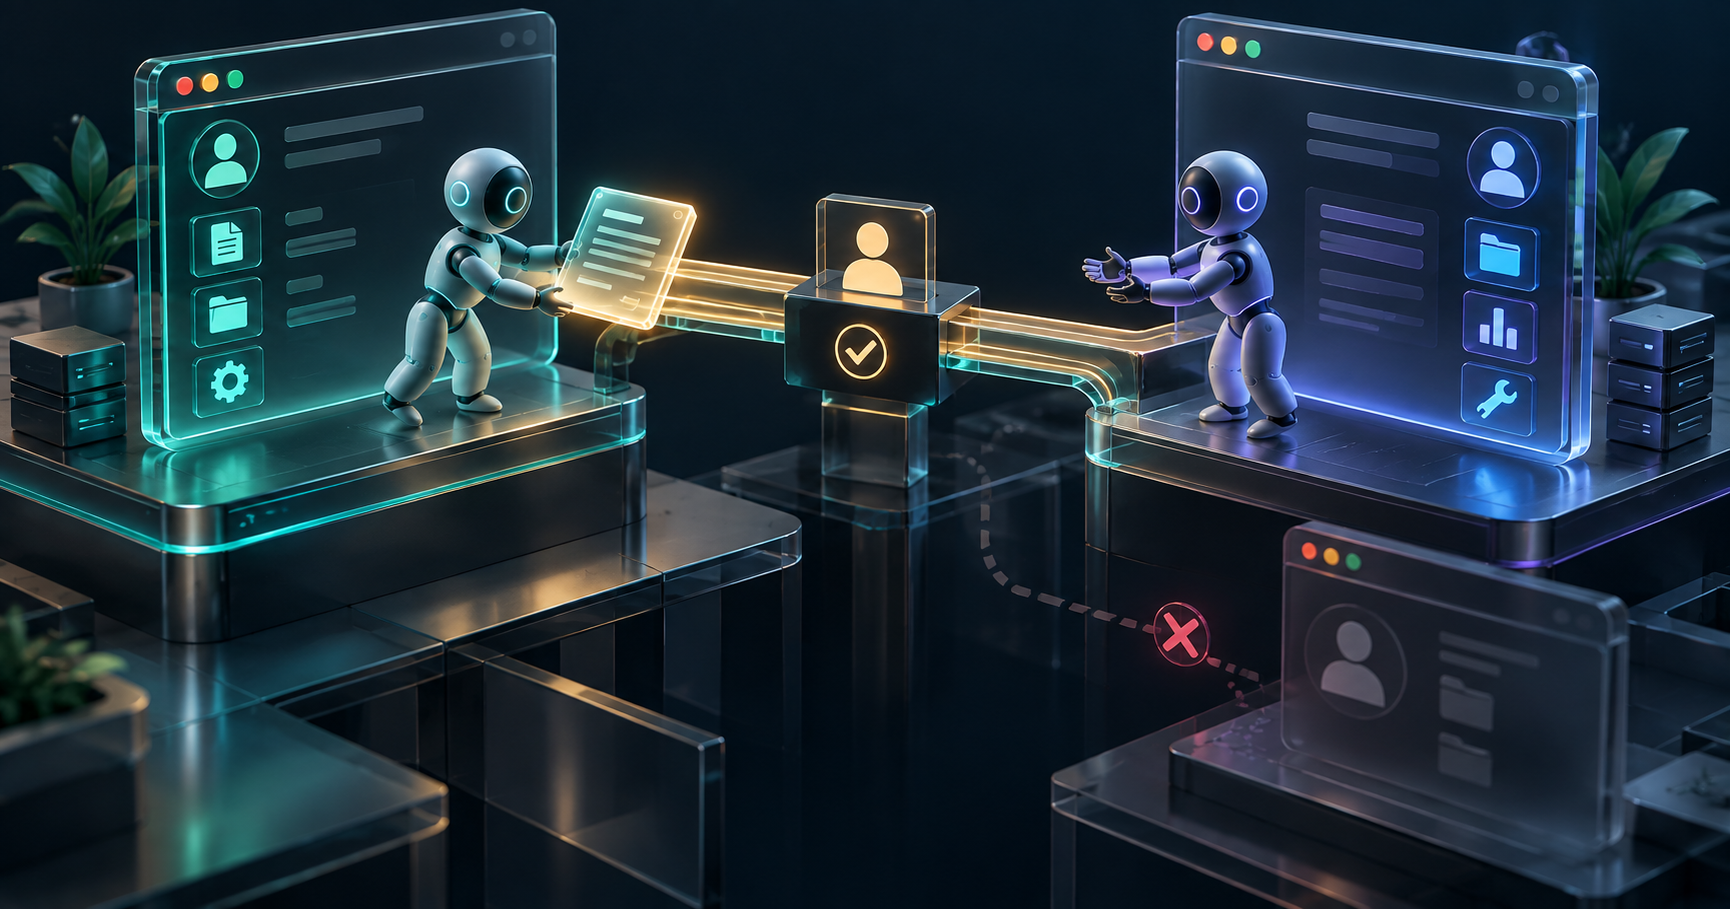
「人の検収」は、外に出る操作の直前に置きます。公開・送信・配置は、AIが下書きまで作り、人が押す。途中の工程に人を入れるより、最後の一手に絞ったほうが、確認の回数は減って見落としも減りました。実行中の権限をどう点検するかは別の記事に、3か所の止め方として書いています。
次の一歩:自分の仕事を5列で書き出す
AIに任せている、または任せたい仕事を、「時刻・仕事・担当・場所・人の検収」の5列で書き出します。担当の列は、最初はモデル名を書かず「判断が要る/照合できる/AI不要」の3つから選びます。場所の列は「毎日決まって動くか」で決まります。人の検収の列が全部「—」になったら、どこかに外へ出る操作が隠れています。そこを見つけたら、その直前に人を置きます。
分担表の時刻と担当、15日間の比較(一致15日、費用1.17ドル対0.035ドル、所要15.5秒対10.5秒)は当サイトのサーバーの記録(2026年10月19日〜11月2日)に基づく事実です。「分けるべきは合格条件を書けるかどうか」は、その記録から当サイトが引いた解釈で、他の仕事に同じ結果が出るとは限りません。モデルの単価と提供状況は提供元の公開情報で、今後変わります。
モデルの版が替わった日や、分担を入れ替えた日に、同じ入力での結果の違いを分かる言葉でお送りします。登録は無料で、いつでも解除できます。
無料で受け取る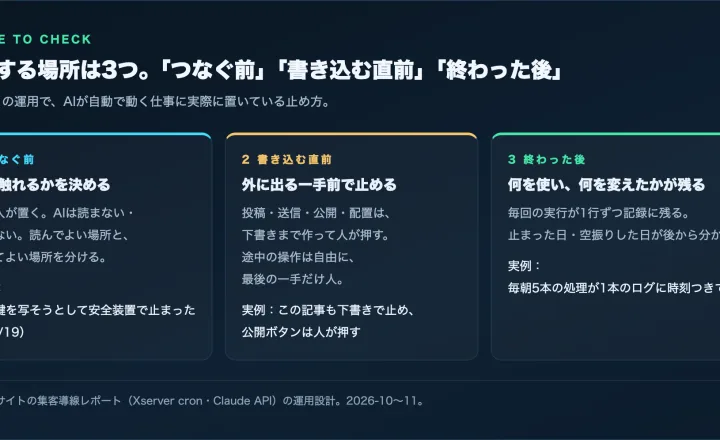


この記事へのコメントはありません。